跳至主要內容

AI ENGINEERING & DEPLOYMENT · 人工智能工程與部署

從 AI 模型到實際應用,一站式工程交付

由 AI 應用整合、模型部署,到所需的私有化環境與基建工程——按你的數據要求與業務需要,建立真正可用、可持續運行的 AI 系統。

軟硬件與 AI 由同一支工程團隊交付,客戶全程只需對接一個責任窗口。

HOW AI FITS IN

企業數據 → AI 模型 → 業務應用

  • 內部文件AI 知識助手
  • 業務數據分析與報告
  • 攝影機影像即時辨識
例子僅供理解,實際方案按項目評估
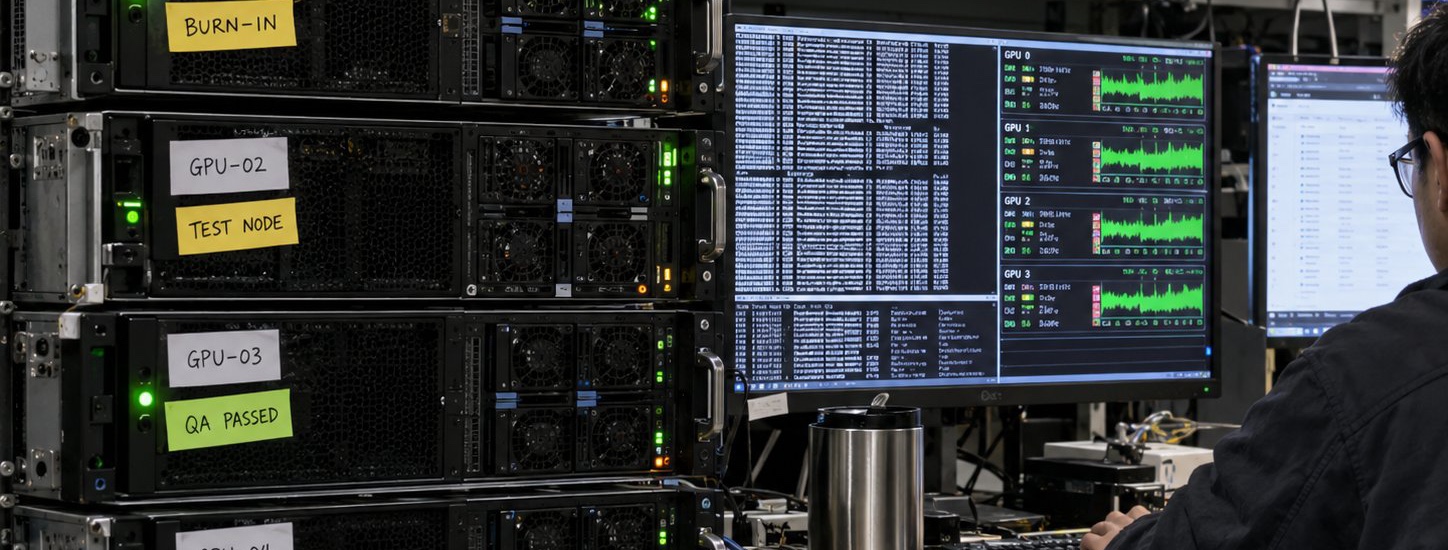
工程師在燒機測試台上監察 GPU 伺服器的運行數據
GPU 伺服器交付前的燒機測試實況
01BEFORE ANY SOLUTION · 先建立認知

30 秒釐清:你的企業真的需要客製化 AI 嗎?

四個初次評估 AI 專案最常見的誤解,逐題一句話解答。

01通用工具企業系統

訂閱 ChatGPT 還是客製 AI?

通用 AI 服務答得到一般問題,但無法接入你公司的內部數據與業務流程。

通用 AI 訂閱獨立網頁或 App資料手動複製貼上
客製 AI 方案接入你現有的系統自動讀取業務數據
02公有雲私有化

伺服器:一定要自建嗎?

不一定。可先由公有雲開始,數據需要留在公司內部時,才評估私有部署;即使自建硬件,選型、組裝與測試都由我們處理。

03上下文檢索重新訓練

模型:需要重新訓練嗎?

多數情況不需要從零訓練。以你的業務資料建立知識與上下文,接入現有系統即可;確有需要時,才評估專屬模型。

從零訓練大量數據收集與標註成本高且需持續更新
上下文檢索使用現成模型帶入你的業務資料
04不需改變工作習慣

交付後:團隊怎麼使用?

AI 直接融入你現有的網頁、內部系統或 API——使用方式按項目設計,以你團隊平日的工具為準。

02SERVICES & SCENARIOS · 服務與場景

AI 工程服務與應用場景

先由你認得的場景出發,再對應我們提供哪一類工程服務。

常見起點企業知識助手AI 文件處理AI 數據分析本地影像 AI
你的 AI 應用
AI 模型與服務
按需求選擇部署環境
公有雲
私有伺服器
邊緣設備
部署方式按數據要求、效能需要與使用環境評估。
部署環境的選擇分支

AI 接入你現有的系統與流程

AI 應用與系統整合

將 AI 接入現有網站、App、SaaS 或企業工作流程;按項目需要建立文件處理、知識問答、數據分析或智能客服。

技術細節(工程用)
  • 既有系統與工作流程對接
  • 企業 RAG:答案附可追溯出處
  • 文件解析與結構化擷取
  • REST / gRPC 雙協議端點
TOOLSRAGREST / gRPC

按實際工作負載,優化推理效能與資源使用

模型部署與效能優化

將合適的 AI 模型部署到指定環境,並按需要處理推理效能、資源使用與服務穩定性。

技術細節(工程用)
  • INT8 / FP8 量化,降低顯存佔用
  • 批次與 KV-cache 調度,提高單卡吞吐
  • 自動擴縮容與負載均衡
  • 雲端或本地皆可部署
TOOLSvLLMTensorRTONNX RuntimeCUDA

支援本地部署,按需要離線運行

私有化與邊緣 AI

為有數據保密、低延遲或離線運行要求的場景,評估本地伺服器、邊緣設備或私有環境。

技術細節(工程用)
  • 氣隙 / 離線部署
  • 邊緣推理盒(Jetson 等)
  • 私有 K8s 推理集群
  • 內網負載均衡與高可用
TOOLSKubernetesDockerGrafana

由環境建置、部署到後續監控,按項目需要提供工程支援

AI 基建與持續運維

按工作負載提供 GPU 伺服器、推理環境、集群、監察及模型更新等相關工程服務。

技術細節(工程用)
  • 按負載選型:GPU、主機板、散熱、供電
  • 機箱與風道設計
  • 燒機測試與出廠校驗
  • 機櫃佈線與上架
  • 模型註冊與灰度發佈
  • 漂移監控與告警
TOOLSNVIDIA GPUProxmox / KVMPrometheusMLflow

不只接入 API,更處理 AI 落地所需的工程整合。如果只是簡單調用公有雲 API,未必需要完整的部署工程;當項目涉及現有系統整合、數據處理、效能優化或私有化部署,我們可以按實際需要提供相應的工程支援。

03DELIVERY PHASES

交付流程 · 由評估到運維

  1. 1
    Assess
    需求評估

    了解使用場景、數據要求及運行規模

    交付成果 · DELIVERABLE
    初步技術方案
  2. 2
    Design
    架構設計與整合

    選擇合適的模型、系統及部署方式

    交付成果 · DELIVERABLE
    確認後的技術方案及實施計劃
  3. 3
    Deploy
    部署與測試

    完成所需的軟件、模型及基建整合;如需自建硬件,此階段包含組裝、佈線與燒機測試

    交付成果 · DELIVERABLE
    經測試的 AI 系統或部署環境
  4. 4
    Operate
    上線與維護

    按項目需要提供監控、優化及持續支援

    交付成果 · DELIVERABLE
    運行文件、監察及維護安排
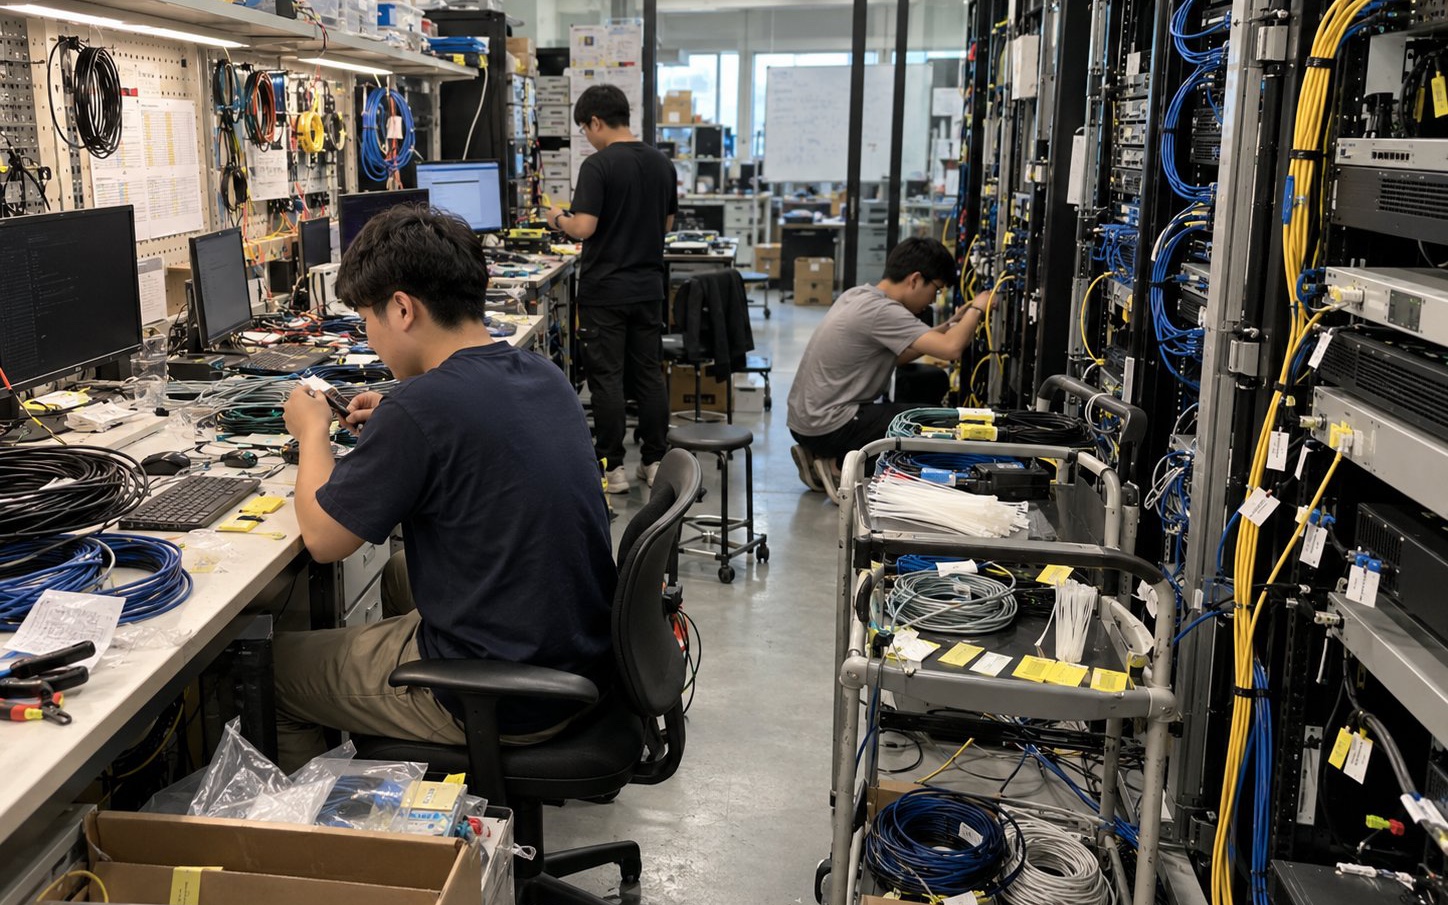
實驗室內的系統組裝與布線工作
交付流程中的組裝、布線與測試實況
04WHY UB FOX

算法到機架,一張責任單

純 AI 團隊交付模型後,往往要等待第三方採購、組裝與部署硬件;硬件團隊則未必理解推論的顯存與延遲約束。我們兩者皆備,因此不必在模型與機器之間留下一段無人負責的空白。

分開採購

多方介面,由你統籌

  1. 01你提出需求
  2. 02AI 團隊交付模型
  3. 責任空白帶
  4. 03硬件供應商交付機器
  5. 04上線與運維

UB Fox

單一窗口,負責到運維

ONE WORK ORDER

  • 模型、機器與上線,同一份合約
  • 出問題時,不必在三家之間對質
  • 保固與運維,同一支團隊接手

兩條採購路徑的交接點

05DEPLOYMENT OPTIONS · 部署方式

按需求選擇部署方式

雲端、私有化或邊緣——取決於你的數據要求、延遲需要與網絡環境,並非每個項目都要自建伺服器。
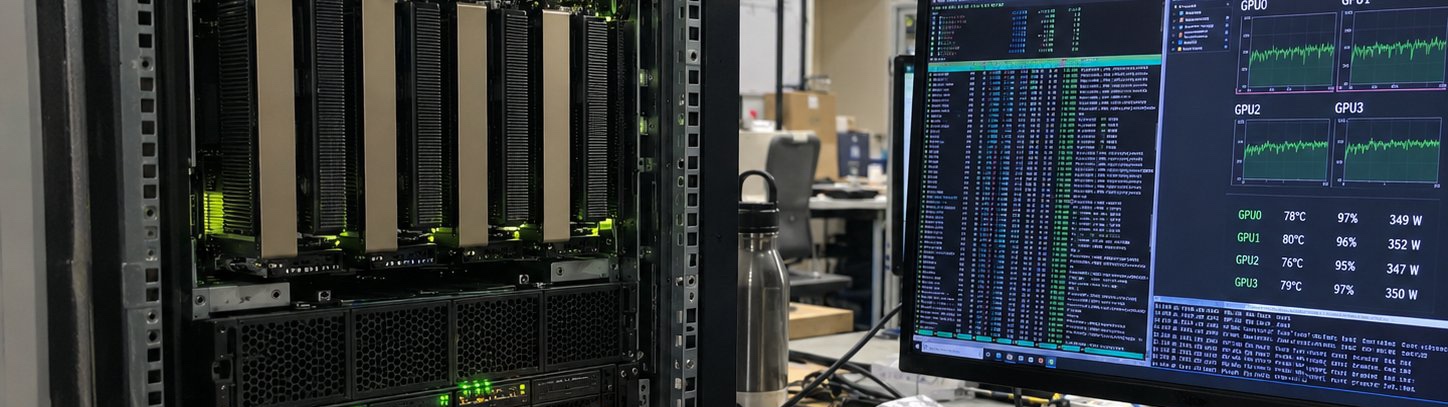
機架內組裝完成的 GPU 伺服器與即時監控畫面
DEPLOYMENT FORMS

部署形態

可用顯存 · 對數刻度
  • 適合單一店舖或機位的離線 AI 盒
    邊緣推理盒· 16 GB

    單一機位、斷網亦可運行

  • 適合部門日常的廠內伺服器
    廠內單卡伺服器· 80 GB

    部門共用,數據不出廠

  • 適合全公司生產負載的多卡集群
    專用多卡集群· 640 GB

    全公司生產負載

部署形態與可用顯存量級
組裝與測試中的多 GPU 運算設備
為部署方案組裝的 GPU 運算設備
06DELIVERY RECORD · 交付紀錄

推論上線之後,實際發生的事

以下每一項均取自專案紀錄,並可點入完整案例。數字為交付後量測結果,並非估算。

精密製造2024

與模型推論直接相關

產線 AI 視覺瑕疵檢測

邊緣推論盒與自研標註流程,取代 60% 人手目檢工位;單張推論 23ms,漏檢率 0.8%。

−60%
目檢人力
0.8%
漏檢率
23ms
單張推論
Computer VisionEdge AITensorRT
07THE UB FOX ADVANTAGE · 核心優勢

同一件事,三種採購方式的分別

交付範圍
算法與機器,一份合約交付
延遲與推論調優
量化、編譯、批次,全鏈路調優
數據駐留 / 氣隙
氣隙與離線部署均可
責任窗口
單一窗口,負責到運維

此表描述三類供應商的典型形態,並非每一家。若你已有硬件,我們亦可只承接算法與部署。

08AI 落地評估

先估規模,再談規格

選擇一項用途與一個使用規模,即時得出部署形態、硬件級別與預算級別。

你希望 AI 負責什麼?
使用規模

點選選項即時重算

文案 / 內容生成 · 團隊 / 部門日常13B · FP16 · 廠內單卡伺服器
顯存需求33 / 80 GB
預計回應
極速 · 30 毫秒內
部署形態
廠內單卡伺服器
所需硬件
單卡 80GB 級
預算級別
標準
技術細節(工程用)
建議硬件
單卡 · 80GB 級(如 A100 80GB)
顯存需求
33 GB
所選規模可用
80 GB
參考延遲 · 量級示意
26 ms

顯存需求按 FP16 權重加上快取餘量估算;參考延遲為量級示意,實際數字隨硬件、批次、上下文長度與量化方式變動。

可容納:模型約需 33 GB,所選形態提供 80 GB。

估算參考值,確切規格以工程評估為準。

預約工程評估